프로젝트의 스케줄 작업은 전부 코드 한 줄에 기대고 있었다. if("1".equals(GkConstant.WAS_NUMBER)). WAS 두 대가 똑같은 @Scheduled 메서드를 갖고 있지만, VM 옵션의 시스템 프로퍼티가 1인 서버에서만 실제로 배치가 돈다.
인프라를 Autoscaling 구성으로 전환하는 일정이 잡히면서 이 한 줄이 문제가 됐다. 서버가 동적으로 생기고 사라지면 “1번 서버"라는 이름을 붙일 대상이 없다. 서버가 몇 대든 배치가 정확히 한 번 돌게 하려면, 실행 시점을 정하는 주체를 서버 밖으로 빼야 했다. 이 글에서는 그 판단과, EventBridge Scheduler와 Lambda로 트리거를 옮긴 과정을 정리한다.
1번 서버라는 기준
기존 환경은 이랬다.
Autoscaling이 적용되지 않은 WAS EC2 2대
Spring Framework 애플리케이션 안에서
@Scheduled로 스케줄 작업 실행
장기 미사용 관리자에게 알림 메일을 보내는 배치가 대표적이다.
@Scheduled(cron = "0 30 9 ? * *", zone = "GMT+9:00")
    public void notifyLongTermNoUseAdmin() {
        if("1".equals(GkConstant.WAS_NUMBER)) { // STG, PRD 의 1번 서버인 경우에만 Batch 실행
            try {
                List<LongTermNoUseAdminVO> notifyAdminDataList = longTermNoUseAdminSvc.getNotifyAdminDataList();

                for (LongTermNoUseAdminVO voNotifyAdmin : notifyAdminDataList) {
                    try {
                        List<String> mailReceiverIDList = new ArrayList<>(Arrays.asList(voNotifyAdmin.getAccountId())); // 메일 수신인 리스트에 장기 미사용자의 이메일 주소만 추출해 추가

                        // 대상자별 mail template parameter 가 다르기 때문에 for 문을 통해 개별 메일 발송
                        awssesClient.sendEmail(mailReceiverIDList, "[" + ospAppConfig.getGkServerType() + "]" + MailEnum.NOTIFICATION.getMailSubject(),
                                setMailHtmlBody(MailEnum.NOTIFICATION, voNotifyAdmin), null);

                        LOG.info("##### SUCCESS Sending Notification Email : {}, {}", voNotifyAdmin.getSaGuid(), voNotifyAdmin.getAccountId());
                    } catch (Exception e) {
                        e.printStackTrace();
                        LOG.info("##### FAIL Sending Notification Email : {}, {}", voNotifyAdmin.getSaGuid(), voNotifyAdmin.getAccountId());
                    }
                }
                LOG.info("##### SUCCESS notifyLongTermNoUseAdmin Batch");
            } catch (Exception e) {
                e.printStackTrace();
                LOG.info("##### FAIL notifyLongTermNoUseAdmin Batch");
            }
        }
    }
cron은 두 서버 모두에서 매일 09:30에 깨어나지만, 실제로 메일을 보내는 건 WAS_NUMBER가 1인 서버뿐이다. 서버 대수가 고정되어 있고 사람이 서버마다 번호를 붙여 두는 동안에는 문제가 없는 방식이다.
Autoscaling이 이 조건을 깨는 방식
Autoscaling 그룹의 인스턴스는 같은 Launch Template으로 찍혀 나온다. 번호를 어떻게 붙이느냐에 따라 결과는 둘 중 하나다.
모든 인스턴스가
1을 갖는다. 서버가 세 대로 늘면 같은 메일이 세 번 나간다.아무 인스턴스도
1을 갖지 않거나,1을 가진 인스턴스가 스케일 인으로 종료된다. 배치가 아예 돌지 않는다.
중복 실행이든 누락이든, 원인은 서버가 자기 자신이 실행 담당인지 스스로 판단한다는 데 있다. 서버 수가 고정일 때만 그 판단이 맞는다.
ShedLock 대신 트리거를 밖으로 뺀 이유
멀티 서버 환경에서 Spring 스케줄 중복 실행을 막는 흔한 방법은 ShedLock의 @SchedulerLock이다. 공유 저장소에 락을 걸어 한 서버만 실행하게 한다. 그런데 이 프로젝트는 Spring Framework 버전이 낮아서 이런 최신 라이브러리를 적용하기 어려웠다.
그래서 방향을 바꿨다. 서버들이 “누가 실행할지"를 합의하게 만드는 대신, 서버 밖에서 정해진 시각에 API를 한 번 호출한다.
AWS EventBridge Scheduler가 매일 09:30에 Lambda를 호출한다.
Lambda가 WAS 앞에 있는 Internal ALB의 DNS로 요청을 보낸다.
요청을 받은 애플리케이션 서버가 (수정된) 스케줄 로직을 실행한다.
flowchart LR
    S["EventBridge Scheduler<br/>매일 09:30"] -->|"{'key': 'admin/...'}"| L["Lambda<br/>gk-*-scheduling-lambda"]
    L -->|POST| A["Internal ALB"]
    A --> W1["WAS 1"]
    A -.-> W2["WAS 2"]
    A -.-> W3["WAS N"]
이 방식이 되는 이유는 ALB에 있다. ALB는 요청 하나를 등록된 타겟 중 한 대에만 전달한다. 서버가 두 대든 다섯 대든 Lambda 호출 한 번은 배치 실행 한 번이 된다. 서버는 더 이상 자기 번호를 알 필요가 없고, 스케일 인으로 어떤 서버가 사라져도 남은 서버 중 하나가 요청을 받는다.
Lambda 함수: 경로를 받아 ALB에 POST 하나
Python 코드
로컬에 lambda_function.py를 만들고 아래 코드를 넣었다. ALB 주소는 환경변수 ALB_URL에서 읽고, 이벤트에 key가 있으면 그 값을 경로로 붙인다.
import json
import requests
import os

def lambda_handler(event, context):
    url = os.environ['ALB_URL']
    print("url : ", url)

    print(event)
    if "key" in event :
        print(event["key"])
        url = url + event["key"]

    headers = { "Content-Type": "application/json", "Connection" : "keep-alive" }
    response = requests.post(url, headers=headers, verify=False) # health check 테스트시 주석처리

    # ------CONNECTION TEST CODE------
    # health check 테스트시 아래 블록 주석해제
    # response = requests.get(os.environ['ALB_URL'] + 'common/health', headers=headers, verify=False)
    # content = response.content.decode()
    # print("content:", content)
    # ------CONNECTION TEST CODE------

    if response.status_code == 200:
        return {
            'statusCode': 200,
            'body': json.dumps('API Success')
        }
    else:
        return {
            'statusCode': response.status_code,
            'body': json.dumps('API Fail')
        }
key 덕분에 Lambda 하나로 여러 배치를 부를 수 있다. 운영 로그를 보면 EventBridge 쪽에서 {'key': 'admin/deleteLongTermNoUseAdmin'}, {'key': 'admin/notifyLongTermNoUseAdmin'}처럼 배치마다 다른 경로를 넘긴다.
requests 라이브러리 패키징
Lambda의 Python 런타임에는 requests가 기본으로 들어 있지 않아서, 코드와 함께 압축해 올렸다.
코드가 있는 경로에
requirements.txt를 만든다.내용은 한 줄이다.
requests==2.22.0
이어서 같은 경로에서 라이브러리를 현재 디렉토리에 설치하고, 전체를 zip으로 묶는다.
pip3 install -r requirements.txt -t .
zip -r scheduler.zip .
Lambda 생성과 설정
DEV 기준으로 gk-dev-scheduling-lambda를 만들었다.
| 설정 | 값 |
|---|---|
| 런타임 | Python 3.9 |
| 아키텍처 | x86_64 |
| VPC·서브넷 | WAS가 속한 private 서브넷 2개 |
| 보안그룹 | Gk_dev_lambda (dev ALB로 가는 443 포트 outbound 허용) |
Internal ALB는 VPC 밖에서 닿지 않으니 Lambda도 같은 VPC의 private 서브넷에 넣어야 한다. 보안그룹은 양쪽을 다 열어야 한다. Lambda 쪽 Gk_dev_lambda에 443 outbound를, ALB 쪽 보안그룹에 Gk_dev_lambda로부터의 inbound를 허용한다.
생성이 끝나면 코드 탭에서 “.zip 파일"로 scheduler.zip을 업로드하면 소스와 라이브러리가 함께 올라간다.
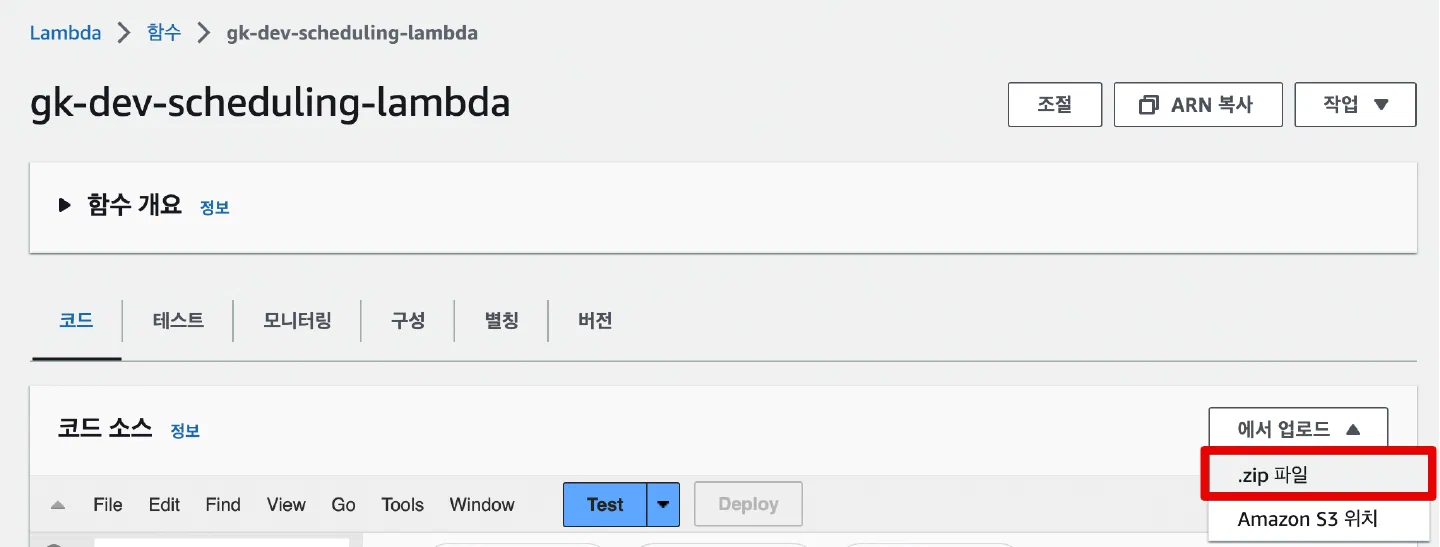
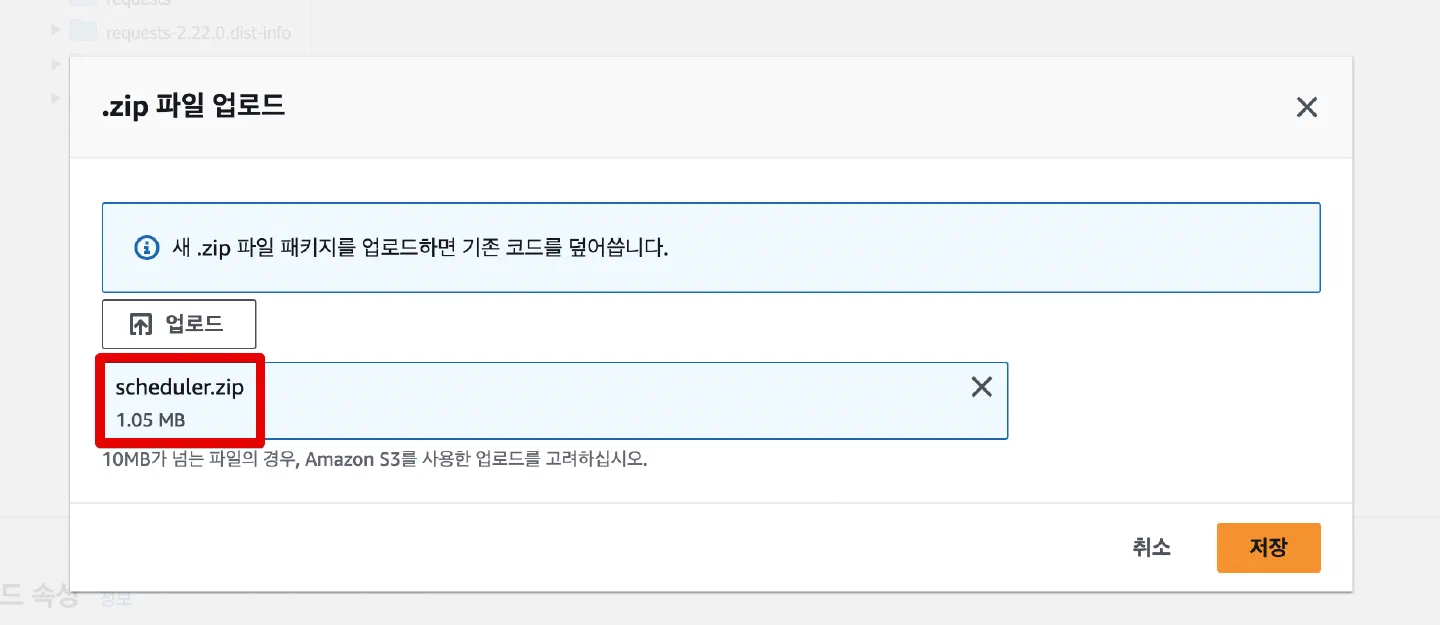
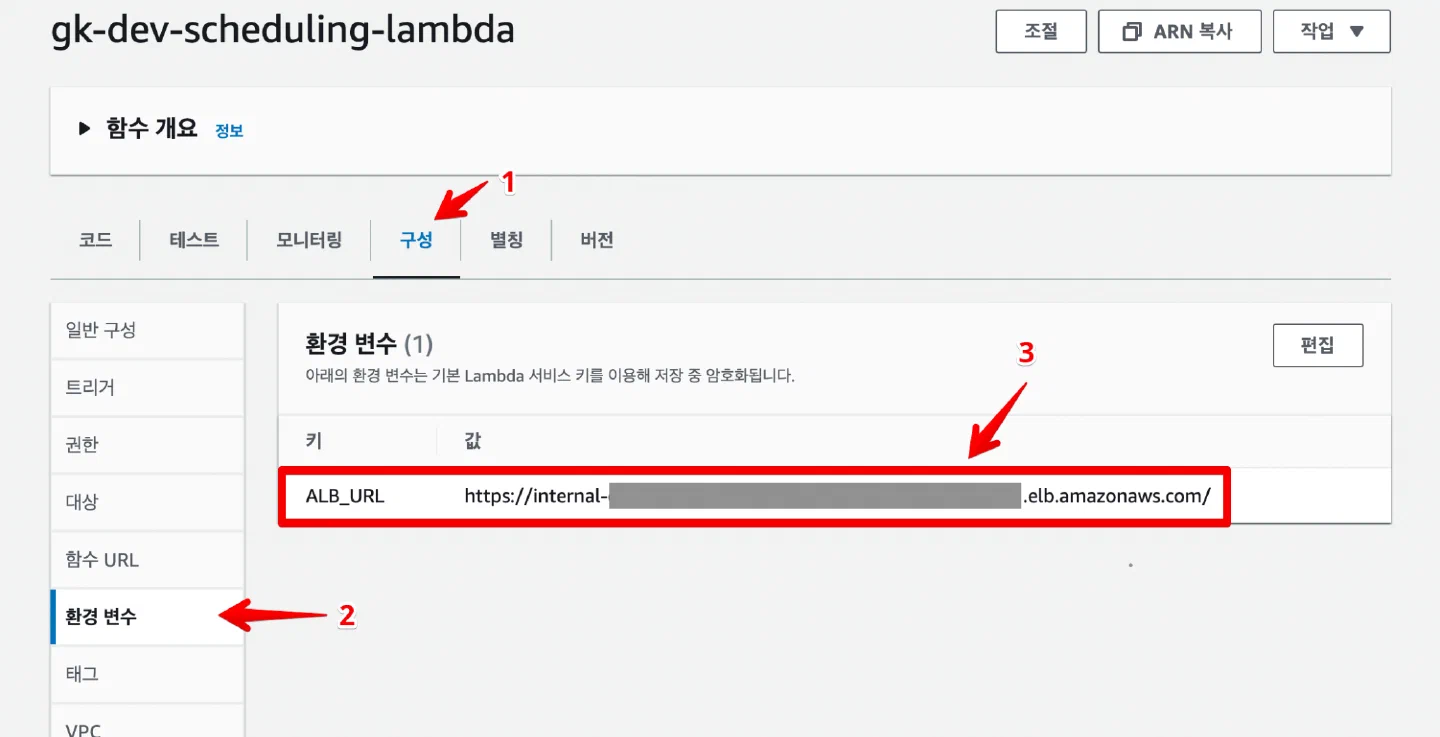
마지막으로 [구성] 탭의 [환경 변수]에서 키 ALB_URL, 값 {Internal-ALB-DNS}로 호출할 로드밸런서 주소를 등록한다.
통신 테스트는 health check로
배치 API를 바로 호출하면 테스트 한 번에 실제 메일이 나갈 수 있으니, Lambda와 WAS 사이 연결은 health check 엔드포인트로 먼저 확인했다. 코드 안에 테스트용 블록을 주석으로 넣어 둔 이유다.
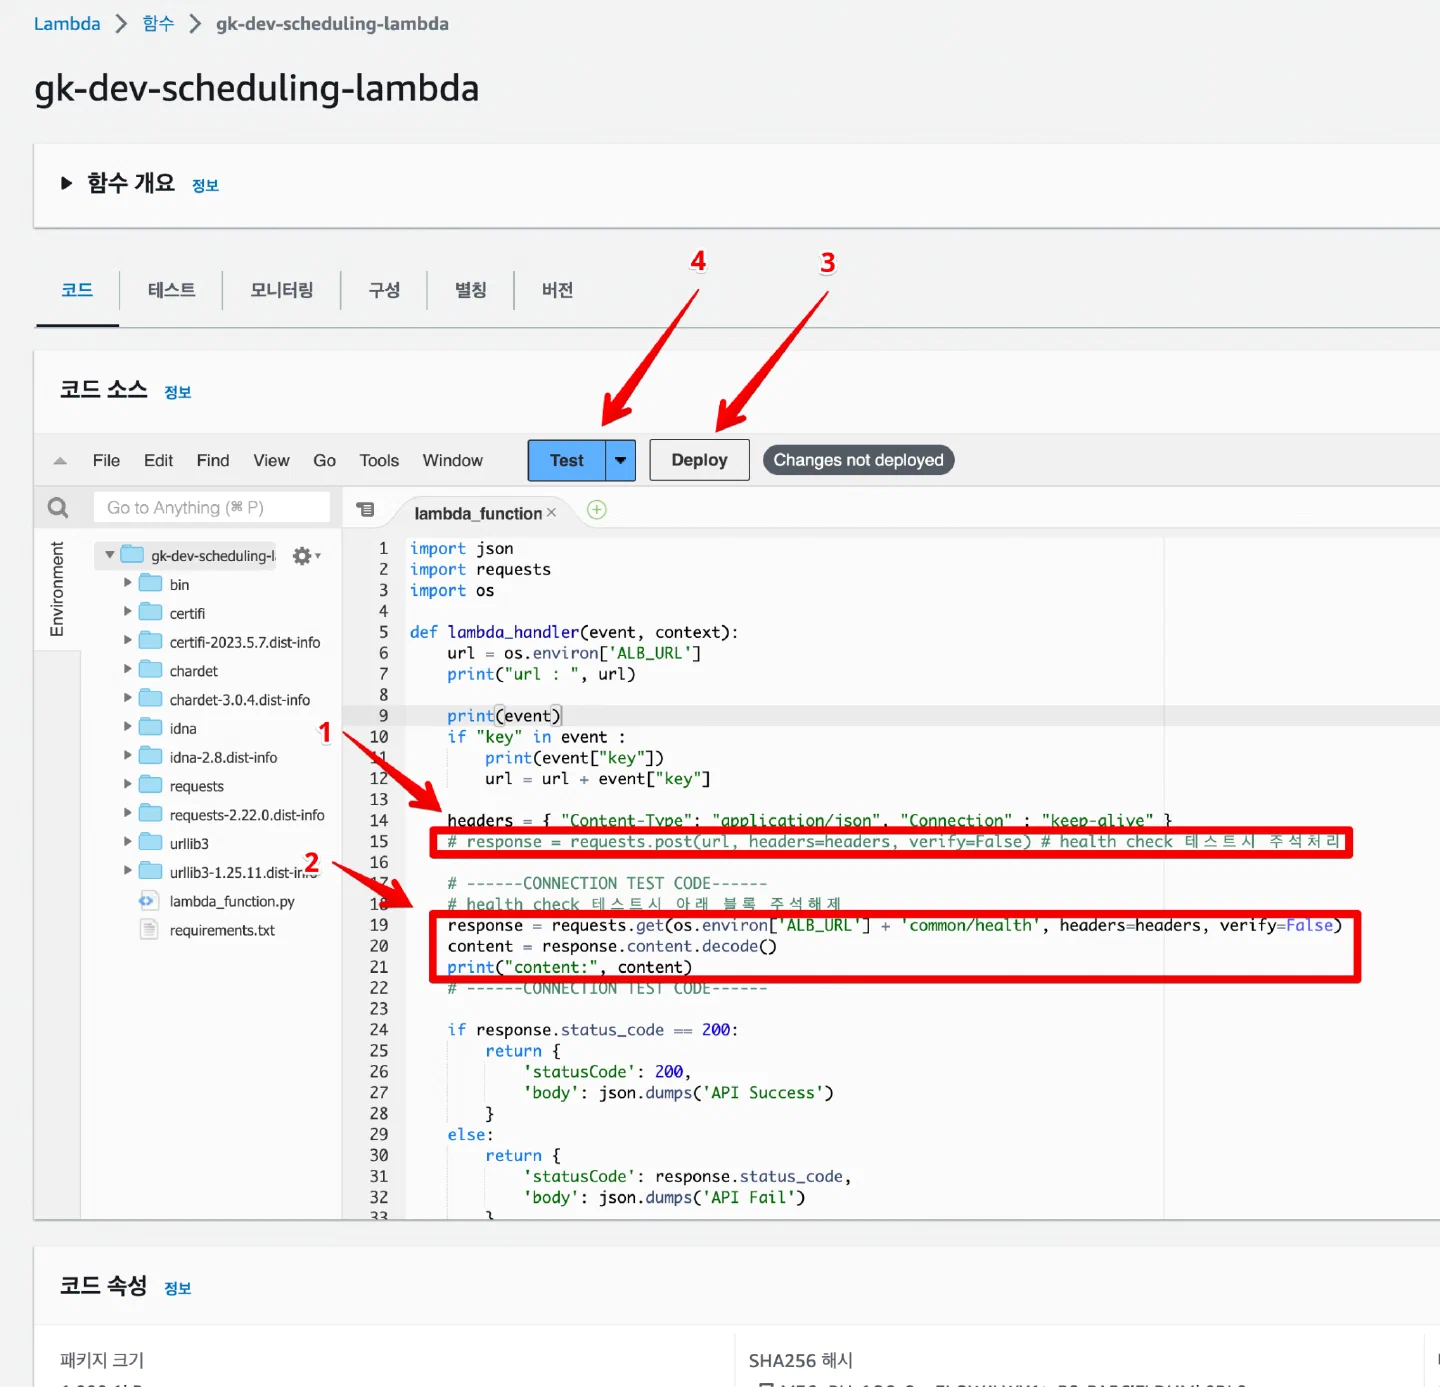
아래 화면의 번호 순서대로 진행한다.
1번
requests.post줄을 주석 처리2번 CONNECTION TEST CODE 블록의 주석 풀기
저장 후 3번 [Deploy]로 배포
배포가 끝나면 4번 [Test]
health check 응답에 “up” → 통신 정상
09:30에 한 번씩 실행됐는지 로그로 확인
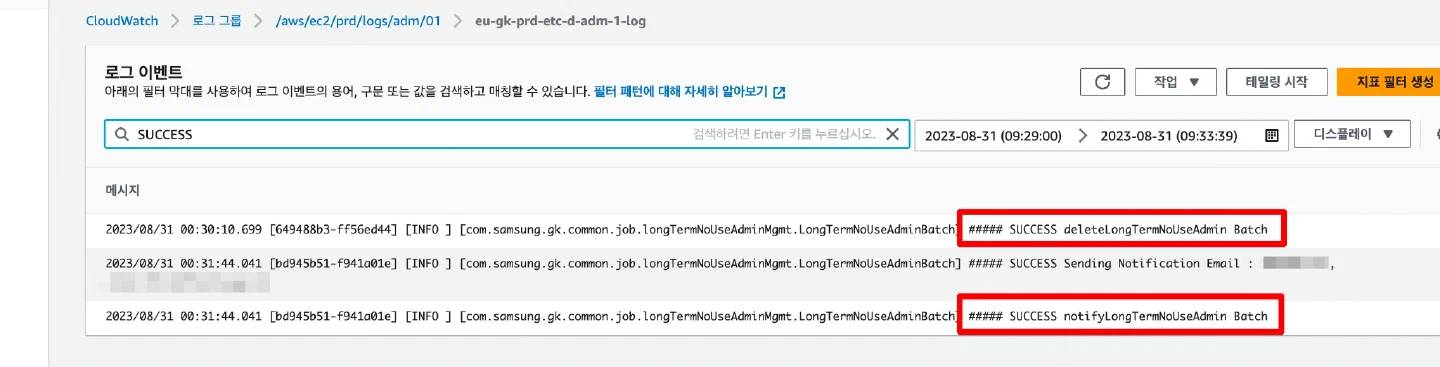
운영 환경에서는 두 군데 로그를 봤다.
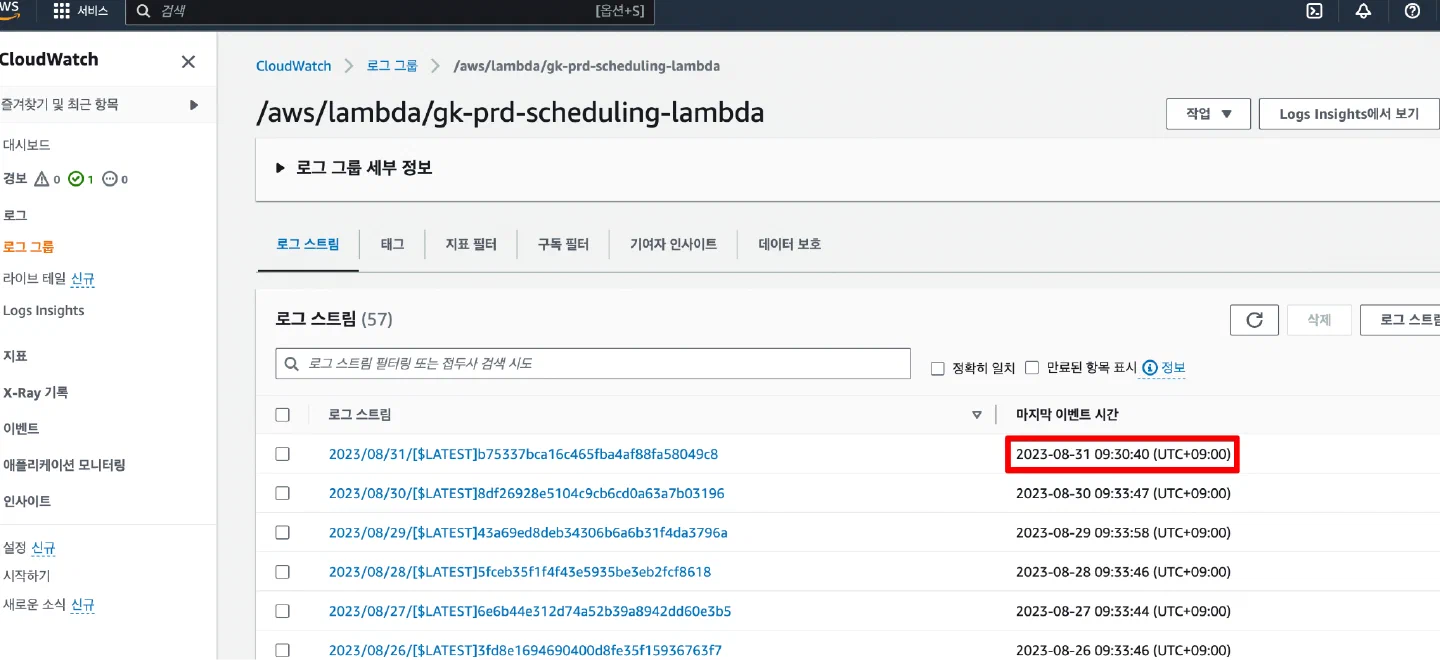
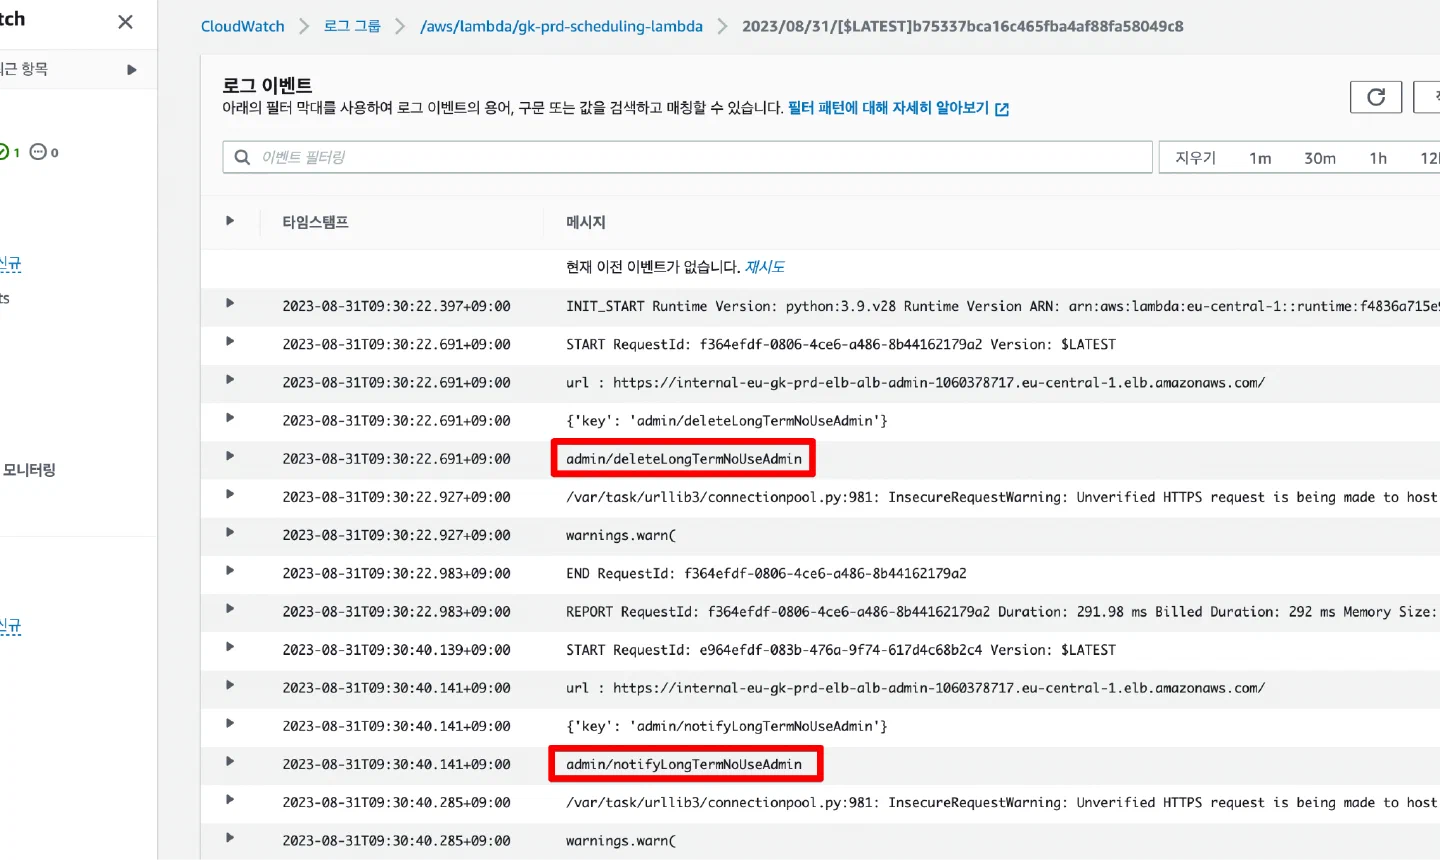
먼저 Lambda 쪽이다. CloudWatch > 로그 그룹 > /aws/lambda/gk-prd-scheduling-lambda에 날마다 로그 스트림이 하나씩 쌓이고, 2023-08-31 스트림의 마지막 이벤트 시간은 09:30:40이다.
스트림 안을 보면 09:30:22에 admin/deleteLongTermNoUseAdmin, 09:30:40에 admin/notifyLongTermNoUseAdmin 경로로 각각 한 번씩 호출됐다.
WAS 쪽은 애플리케이션 로그 그룹에서 SUCCESS로 검색했다. deleteLongTermNoUseAdmin Batch와 notifyLongTermNoUseAdmin Batch의 성공 로그가 각각 한 줄씩 남아 있다.
아직 남은 문제
Lambda는 API가 실패해도 정상 종료한다. 응답 코드가 200이 아니면
'API Fail'을 담은 dict를 반환할 뿐 예외를 던지지 않는다. Lambda 호출 자체는 성공으로 기록되니 EventBridge Scheduler의 재시도도 걸리지 않는다. 실패는 로그를 직접 봐야 알 수 있다.verify=False로 인증서 검증을 끄고 있다. 호출할 때마다InsecureRequestWarning이 로그에 남는 것도 이 때문이다.배치 API는 VPC 안에서 누구나 호출할 수 있는 엔드포인트다. 보안그룹으로 ALB 접근을 좁혀 두긴 했지만, 요청 자체를 검증하는 장치는 코드에 없다.
정리
Autoscaling에서는 “1번 서버"라는 기준이 성립하지 않는다. 같은 템플릿으로 찍힌 서버는 중복 실행하거나 아무도 실행하지 않는다.
실행 시점을 서버 밖으로 빼면 중복 문제가 ALB의 라우팅으로 풀린다. EventBridge Scheduler가 Lambda를 부르고, Lambda가 Internal ALB에 요청 하나를 보내면 서버 한 대만 배치를 돈다.
이벤트의
key를 경로로 붙이면 Lambda 하나로 여러 배치를 부를 수 있다.실패 감지와 재시도, 엔드포인트 보호는 아직 숙제다.
Spring 버전만 받쳐 줬다면 @SchedulerLock 한 줄로 끝났을 일이다. 대신 스케줄이 애플리케이션 밖으로 나오면서, 언제 어떤 배치가 호출됐는지가 Lambda 로그 스트림에 날짜별로 남는다.