Redis 서버에 붙어서 키가 제대로 들어갔는지, 만료시간이 걸렸는지, 큐에 뭐가 쌓였는지 확인할 때 결국 손이 가는 건 redis-cli다. 명령어가 많아 보이지만 규칙이 있다. 앞 글자가 어떤 자료구조를 다루는지 알려준다.
이 글에서는 접속 옵션, 서버 상태 확인, 기본 타입인 String 명령어를 먼저 보고, Hash·List·Set·Sorted Set 네 자료구조를 차례로 정리한다. 운영 서버에서 조심해야 할 명령어는 마지막에 따로 모았다.
접속은 옵션 다섯 개로 끝난다
먼저 Redis가 포트를 열고 있는지 확인한다.
$ netstat -nlpt | grep 6379
(Not all processes could be identified, non-owned process info
 will not be shown, you would have to be root to see it all.)
tcp        0      0 127.0.0.1:6379          0.0.0.0:*               LISTEN      -
접속 옵션은 포트(-p), 호스트(-h), DB 번호(-n), 비밀번호(-a, auth의 약어), 클러스터 모드(-c) 정도면 충분하다.
# 6480번 포트의 redis 서버 접속
$ ./redis-cli -p 6480
127.0.0.1:6480>

# 다른 서버에 있는 6480번 포트의 redis 서버 접속
$ ./redis-cli -h 192.168.124.xxx -p 6480
192.168.124.xxx:6480>

# DB 번호가 0인 redis 서버 접속
$ ./redis-cli -n 0 -p 6480
127.0.0.1:6480>

# 비밀번호가 test인 redis 서버 접속
$ ./redis-cli -a test -p 6480
127.0.0.1:6480>
클러스터에 접속할 때는 -c를 꼭 붙인다. 그래야 get을 했을 때 키가 있는 노드로 알아서 넘어간다.
$ ./redis-cli -p 6480 -c
127.0.0.1:6480> get a
-> Redirected to slot [15495] located at node3:6480
"b"
서버 상태는 info와 monitor로 본다
info는 서버 정보를 섹션별로 보여준다.
$ ./redis-cli -p 6480 info
출력이 길어서 자주 보는 항목에만 설명을 달아 두었다.
# Server
# 레디스 서버에 대한 일반적인 정보

# Clients
# 현재 접속해 있는 클라이언트 수
connected_clients:2
# 대기 중인 클라이언트 수
blocked_clients:0

# Memory
used_memory:3287928
# 현재 사용 중인 메모리
used_memory_human:3.14M
# OS에서 Redis가 실제 차지하는 메모리양
used_memory_rss_human:4.09M
# peak 시 사용한 메모리
used_memory_peak_human:3.14M

# MaxMemory 설정
maxmemory_human:0B
# MaxMemory 초과 시 데이터 처리 정책
maxmemory_policy:noeviction

# Persistence

# Stats
# 서버가 시작된 뒤 받아들인 전체 연결 수
total_connections_received:8
# 현재 처리하고 있는 초당 operation 수
instantaneous_ops_per_sec:0
# 현재 input kbps
instantaneous_input_kbps:0.00
# 현재 output kbps
instantaneous_output_kbps:0.00

# Replication

# CPU

# Modules

# Cluster
cluster_enabled:0

# Keyspace
지금 이 서버에 어떤 명령이 들어오는지 실시간으로 보려면 monitor, 주요 통계를 주기적으로 찍어 보려면 --stat을 쓴다.
$ redis-cli -p 6480 monitor
OK

$ redis-cli -p 6379 --stat
프롬프트에 들어가지 않고 명령을 바로 넘길 수도 있다. 포트가 연달아 있는 여러 서버에 같은 명령을 돌릴 때는 셸 반복문과 묶는다.
$ redis-cli -p 6379 keys "*"

# 6001~6010번 포트 서버의 키 개수를 한 번에 확인
$ for i in {6001..6010}; do src/redis-cli -p $i dbsize; done
가장 기본인 String 명령어
접두어가 없는 명령어는 대부분 String을 다룬다. 저장·조회·삭제부터 보자.
# 키, 값 저장
set {key} {value}

# 특정 키 값 조회
get {key}

# 여러 개의 key, value를 한 번에 저장
mset {key} {value} [{key} {value} ...]

# 여러 개의 key에 해당하는 value를 한 번에 조회
mget {key} [{key} ...]

# 특정 키 삭제 (여러 개를 한 번에 지울 수도 있다)
del {key} [{key} ...]
127.0.0.1:6379> MSET username assu userage 20 usercity seoul
OK

127.0.0.1:6379> MGET username usercity
1) "assu"
2) "seoul"

127.0.0.1:6379> GET usercity
"seoul"
키 자체를 살피는 명령어도 있다.
keys *          # 서버 내 모든 key 조회
keys *te*       # 특정 문자열을 포함하는 key 조회
                # 1) "test1"
                # 2) "test2"
exists {key}    # key 존재 여부
randomkey       # 랜덤으로 key 하나 조회
type {key}      # key의 타입 조회
dbsize          # 서버 내 key 전체 개수
flushdb         # 현재 선택된 DB의 모든 데이터 삭제
flushall        # 서버 내 모든 데이터 삭제
만료시간
ttl로 남은 만료시간을 초 단위로 본다. -1은 만료시간이 없는 키, -2는 키가 없다는 뜻이다(만료되어 사라진 경우 포함).
ttl {key}

# 30초 뒤 만료되도록 저장
set {key} {value} EX 30

# 값을 덮어쓰면서 남아 있던 만료시간은 유지 (Redis 6.0부터)
set {key} {value} KEEPTTL

# 이미 있는 키에 만료시간 설정
EXPIRE tutorialspoint 60
(integer) 1    # 설정 완료
(integer) 0    # 키가 없거나 만료시간을 설정할 수 없는 경우
옵션 없이 set으로 값을 덮어쓰면 걸려 있던 만료시간이 사라진다. 만료시간이 30초로 다시 시작되는 게 아니라 키가 만료되지 않는 상태가 된다. 값을 바꿔도 원래 만료 시점을 지키고 싶으면 KEEPTTL을 붙인다.
조건부 저장과 숫자 증감
set a b nx   # key a에 값이 없을 때만 저장 (있으면 수정하지 않음)
set a b xx   # key a에 값이 있을 때만 수정 (없으면 저장하지 않음)
set a 10
incr a        # 1 증가
get a         # "11"
decr a        # 1 감소

set a 10
incrby a 10   # 10 증가
get a         # "20"
decrby a 10   # 10 감소

# 소수 증감은 INCRBYFLOAT 하나로 처리한다
INCRBYFLOAT a 2.5    # 2.5 증가
INCRBYFLOAT a -2.5   # 2.5 감소
문자열 이어 붙이기와 자르기
append는 현재 값 뒤에 문자열을 붙인다. 키가 없으면 새로 만든다.
127.0.0.1:6480> APPEND greeting Hello  # key가 없으면 생성
(integer) 5

127.0.0.1:6480> GET greeting
"Hello"

127.0.0.1:6480> APPEND greeting World  # 기존 key 뒤에 이어 붙임
(integer) 10

127.0.0.1:6480> GET greeting
"HelloWorld"
getrange, setrange는 각각 substring, replace에 해당한다.
127.0.0.1:6379> SET hello world
OK

127.0.0.1:6379> GETRANGE hello 2 4
"rld"

127.0.0.1:6379> SETRANGE hello 2 ppp
(integer) 5

127.0.0.1:6379> GET hello
"woppp"
명령어 앞 글자가 자료구조를 알려준다
String 말고도 Redis 값은 여러 자료구조가 될 수 있다. 외울 게 많아 보이지만 명령어 앞 글자만 보면 어느 자료구조를 다루는지 바로 알 수 있다.
| 접두어 | 자료구조 | 예 |
|---|---|---|
| 없음 | String | set, get, incr |
h | Hash | hset, hget, hgetall |
l / r | List (왼쪽/오른쪽) | lpush, rpop, lrange |
s | Set | sadd, smembers |
z | Sorted Set | zadd, zrange |
어떤 키가 무슨 자료구조인지 모르겠으면 type {key}로 먼저 확인한다.
Hash
키 하나 아래에 field-value 쌍을 여러 개 담는다.
hset user:1 name An city seoul   # 초기화

# 특정 hash의 특정 field 값 조회
hget user:1 name   # "An"
hget user:1 city   # "seoul"

# 특정 hash의 특정 field 삭제
hdel user:1 name

# 특정 hash의 모든 field-value 조회
hgetall user:1

# 특정 hash의 field만 조회
hkeys user:1

# 특정 hash의 value만 조회
hvals user:1
List
Linked List 형태라서 양 끝에 넣고 빼는 게 자연스럽다. 값이나 인덱스로 데이터를 찾거나 삭제할 수도 있다. 최대 길이는 2^32 - 1(4,294,967,295)이다. 주로 Stack이나 Queue를 구현할 때 쓰고, 백그라운드 작업자 시스템의 대기열이 대표적인 예다.
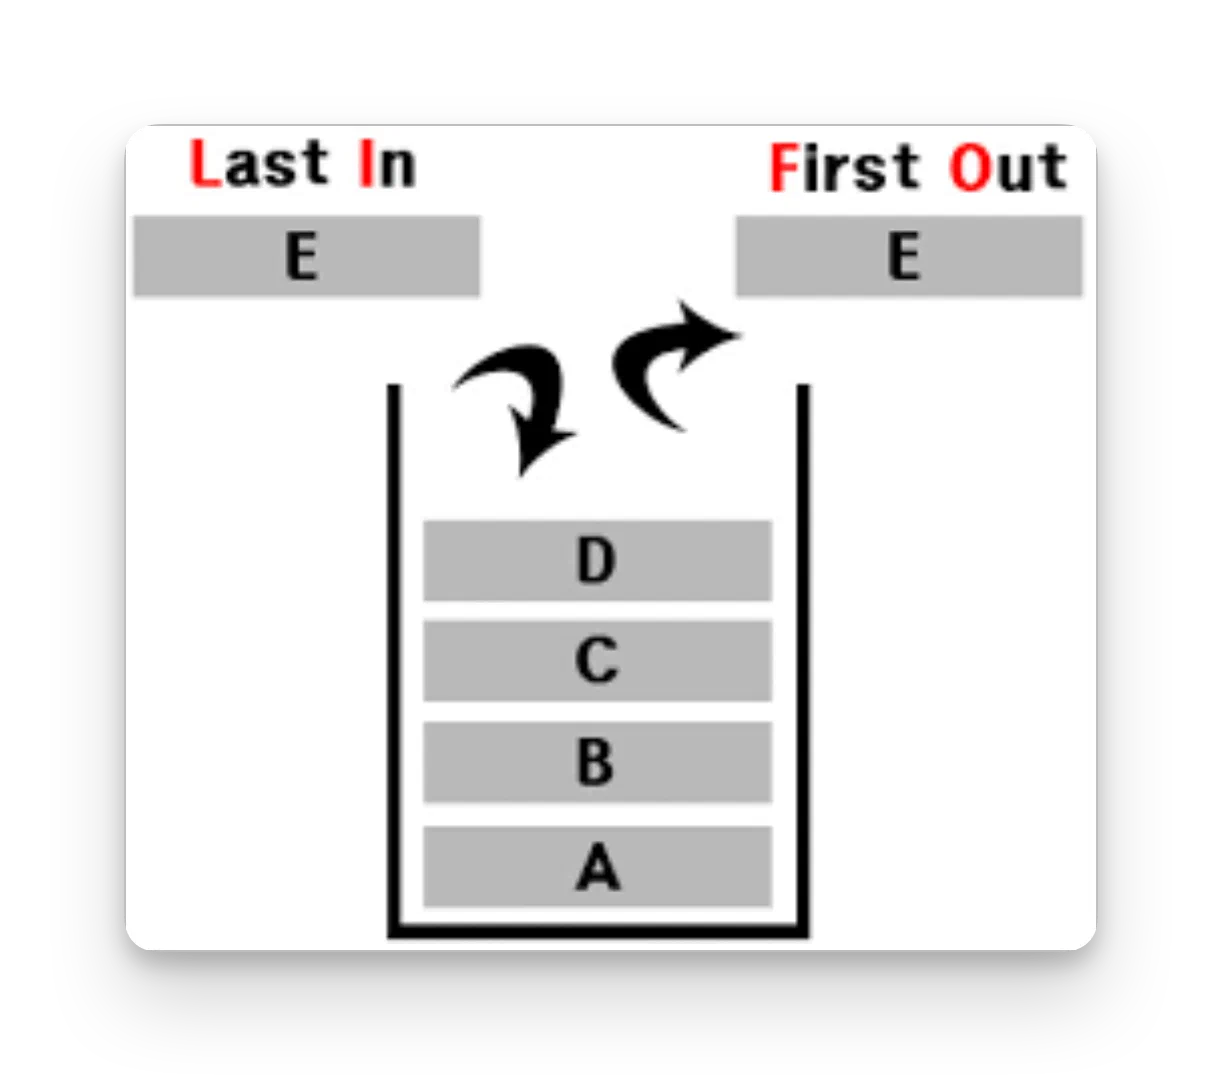
Stack
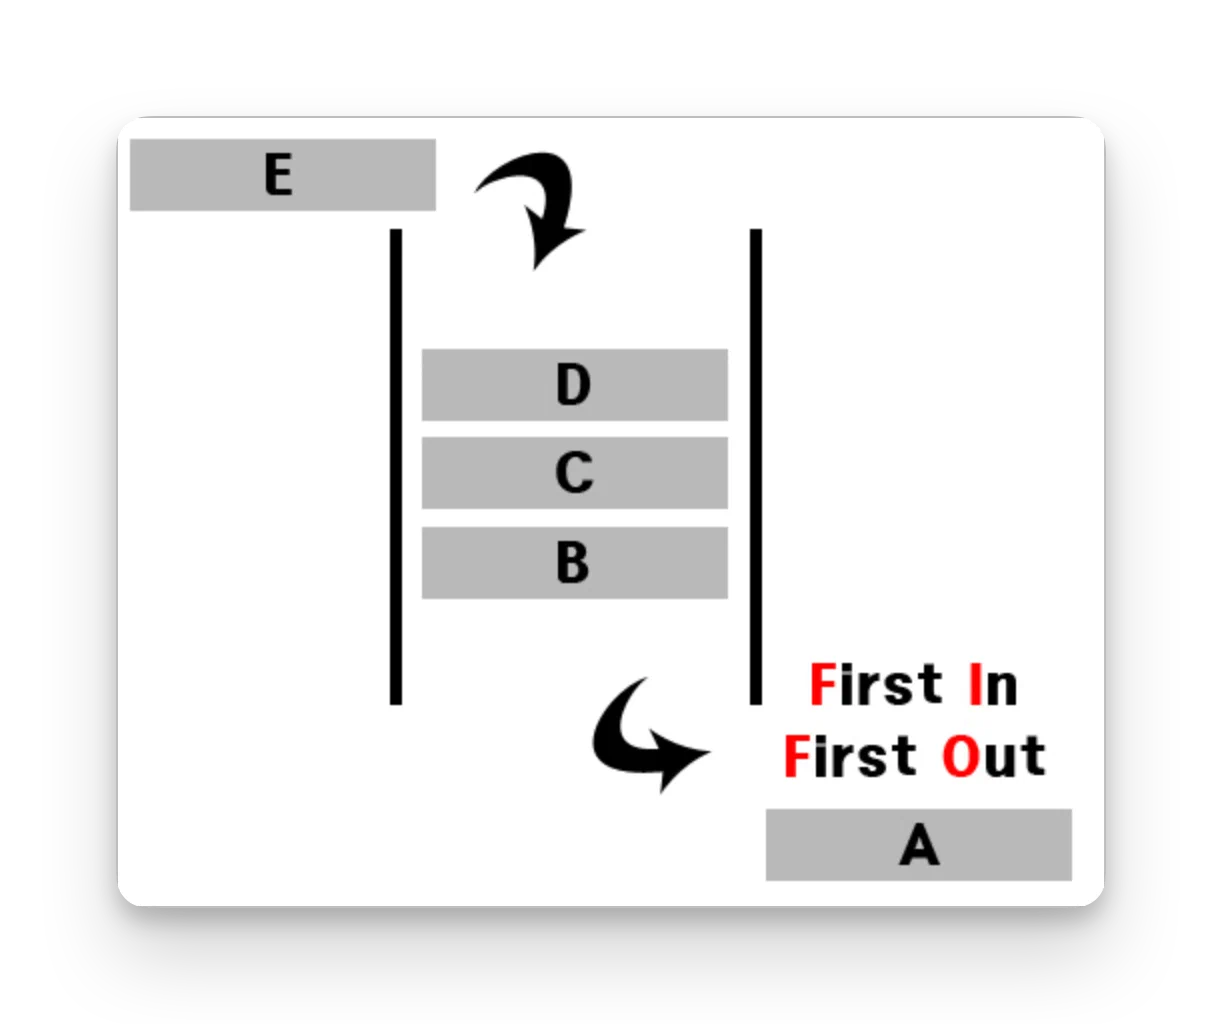
Queue
넣는 쪽과 빼는 쪽을 어떻게 고르느냐에 따라 Queue도 되고 Stack도 된다.
# 생성
lpush {queue name} {value 1}
lpush {queue name} {value 1} {value 2} {value 3} ...

# lpush로 넣었다면
rpop {queue name}   # FIFO 추출 (Queue)
lpop {queue name}   # LIFO 추출 (Stack)
rpush는 오른쪽에 값을 넣으므로 오른쪽으로 갈수록 최근에 들어온 값이다. rpush test-queue A B C라고 하면 A부터 차례로 들어가 [A, B, C]가 되고, 여기서 lpop을 하면 먼저 들어온 순서대로 나온다.
rpush test-queue A B C   # [A, B, C]

lpop test-queue   # "A"
lpop test-queue   # "B"
lpop test-queue   # "C"
값을 꺼내지 않고 들여다보기만 하려면 llen과 lrange를 쓴다.
127.0.0.1:6480> rpush queue-name 1 2 3 4 5
(integer) 5

127.0.0.1:6480> llen queue-name   # 리스트 길이 확인
(integer) 5

# 전체 요소 확인
127.0.0.1:6480> lrange queue-name 0 -1
1) "1"
2) "2"
3) "3"
4) "4"
5) "5"

# 특정 인덱스 값 확인
127.0.0.1:6480> lrange queue-name 0 0
1) "1"
Set
순서가 없고 중복을 허용하지 않는다. 1 1 2 2 3 3 1 1을 넣어도 남는 건 세 개다.
127.0.0.1:6480> sadd set-name1 1 1 2 2 3 3 1 1
(integer) 3

# set 크기 확인
127.0.0.1:6480> scard set-name1
(integer) 3

# 모든 원소 조회
127.0.0.1:6480> smembers set-name1
1) "1"
2) "2"
3) "3"

127.0.0.1:6480> sadd set-name2 1 2 3

# 1이 set에 있는지 확인
127.0.0.1:6480> sismember set-name2 1

# set-name2에서 1 삭제 (remove)
127.0.0.1:6480> srem set-name2 1

# 랜덤하게 원소 하나를 pop
127.0.0.1:6480> spop set-name2
Sorted Set
값마다 가중치(score)를 붙여 정렬해 두는 Set이다. 점수 순으로 줄을 세워 두니 랭킹 기능을 만들 때 먼저 떠올릴 만하다.
# 기본 문법
zadd {SortedSet name} [가중치1] [key1] [가중치2] [key2] ...
zadd test-name 30 a 10 b 15 c
(integer) 3

# 전체 출력 (기본 오름차순)
zrange test-name 0 -1
1) "b"
2) "c"
3) "a"

# 전체 출력 (내림차순, rev 옵션은 Redis 6.2부터)
zrange test-name 0 -1 rev
1) "a"
2) "c"
3) "b"

# 가중치와 함께 내림차순 조회
zrange test-name 0 -1 rev withscores
1) "a"
2) "30"
3) "c"
4) "15"
5) "b"
6) "10"

# zrank: 가중치가 가장 낮은 요소가 0위 (오름차순)
zrank test-name a   # (integer) 2
zrank test-name b   # (integer) 0
zrank test-name c   # (integer) 1

# zrevrank: 가중치가 가장 높은 요소가 0위 (내림차순)
zrevrank test-name a   # (integer) 0
zrevrank test-name b   # (integer) 2
zrevrank test-name c   # (integer) 1

# 가중치가 가장 높은 요소 꺼내기
zpopmax {SortedSet name}

# 가중치가 가장 낮은 요소 꺼내기
zpopmin {SortedSet name}
운영 서버에서는 조심할 명령어
Redis는 명령을 한 스레드에서 하나씩 처리한다. 그래서 오래 걸리는 명령 하나가 그동안 들어온 다른 요청을 전부 기다리게 만든다. 키가 많은 서버의 keys *, 데이터를 통째로 지우는 flushall·flushdb, 필드가 많은 Hash의 hgetall이 그런 명령이다. 로컬에서 연습할 때는 편하지만 운영 환경에서는 쓰기 전에 한 번 더 생각한다. 키를 훑어봐야 한다면 커서로 조금씩 나눠 가져오는 scan이 대안이다.