Redis를 소개하는 글은 대개 특징 목록으로 시작한다. Key-Value, In-Memory, Single Thread, 다양한 자료구조, Replication. 내 메모도 그랬다. 목록은 읽을 때는 다 아는 것 같아도 금방 잊힌다. 다시 정리해 보니 이 중 두 가지, 데이터를 메모리에 둔다는 것과 명령을 한 스레드에서 처리한다는 것에서 나머지 특징 대부분이 따라 나왔다.
이 글에서는 Redis가 무엇인지, 그 두 성질이 어떤 장점과 주의점을 만드는지, 주로 어디에 쓰이는지를 정리한다. 명령어로 자료구조를 직접 다뤄 보는 이야기는 「redis-cli로 Redis 자료구조 손에 익히기」에, AWS ElastiCache에서 Redis를 구성하는 단위는 「ElastiCache for Redis의 노드, 샤드, 클러스터」에 따로 적었다.
Remote Dictionary Server
Redis는 REmote DIctionary Server의 줄임말이다. 이름대로 네트워크 너머에 있는 거대한 딕셔너리다. Key-Value 구조의 비정형 데이터를 저장하고 관리하는 오픈소스 NoSQL DBMS다. 스키마가 고정되어 있지 않아 키마다 원하는 내용만 저장할 수 있고, 값을 키로 바로 꺼내니 SQL 같은 쿼리를 쓸 필요도 없다.
쓰임새는 넓다. 데이터베이스로 쓸 수도 있고, Message Queue나 여러 서버가 함께 보는 Shared Memory로 쓸 수도 있다. 그래도 가장 흔한 쓰임은 Cache Server다.
디스크 대신 메모리에 둔다
인메모리(In-Memory)는 데이터를 하드디스크(SSD, HDD)가 아니라 컴퓨터의 주 기억장치인 RAM에 올려서 쓰는 방식이다. 메모리 계층에서 메인 메모리는 디스크보다 한 칸 위에 있고, 속도는 수백 배 이상 빠르다.
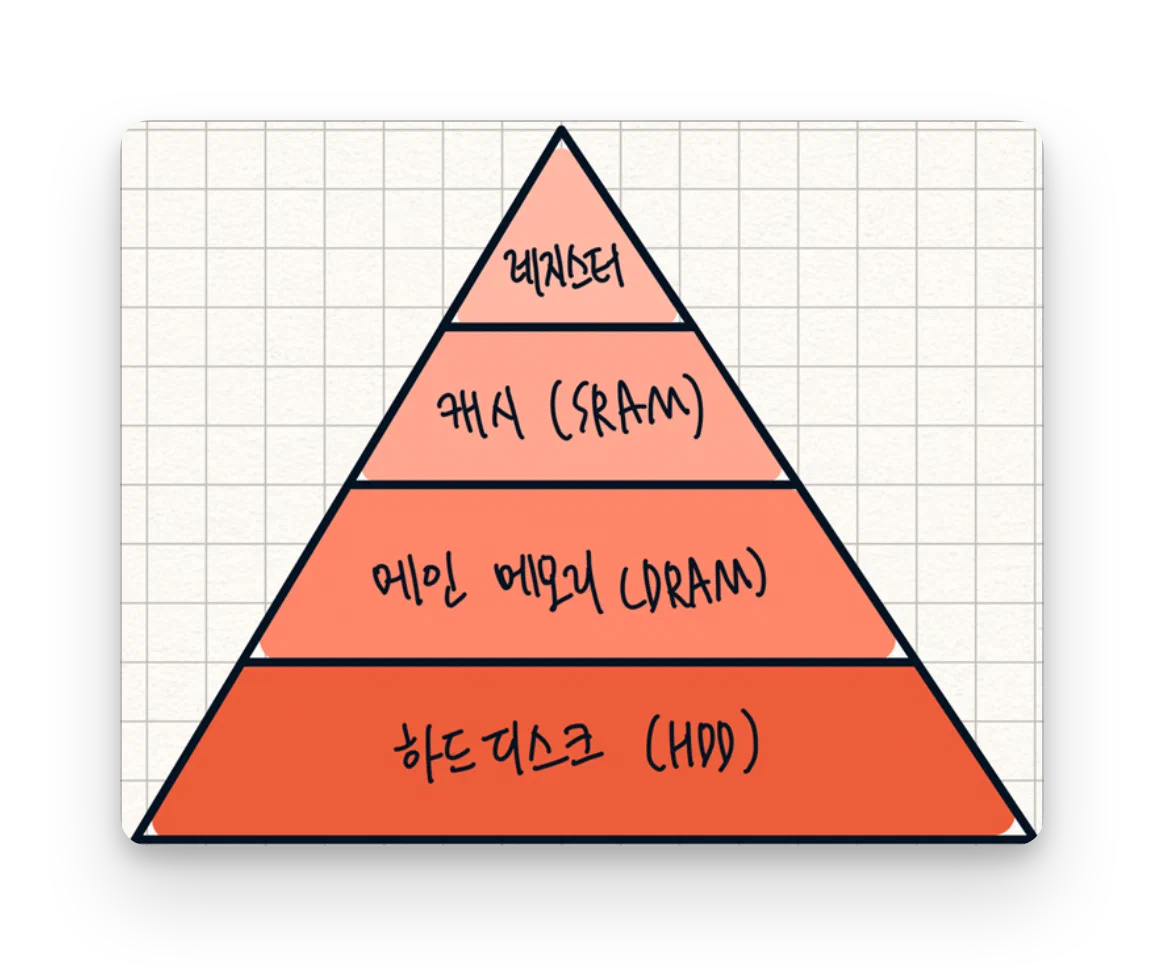
데이터베이스를 두고도 Redis를 따로 쓰는 이유가 여기 있다. 데이터베이스는 물리 디스크에 직접 write하기 때문에 데이터가 손실되지 않는다. 대신 사용자가 많아질수록 디스크에 부하가 쌓인다. 한 번 읽어온 데이터를 Redis에 캐싱해 두면 같은 데이터를 다시 조회할 때 디스크까지 내려가지 않아도 되고, 그만큼 서비스가 빨라진다.
빠른 대신 메모리는 휘발성이다. 영속화 설정 없이 쓰면 서버를 재시작할 때 데이터가 전부 사라진다. Redis는 이를 위해 디스크에 스냅샷이나 로그를 남기는 persistence 옵션을 제공한다. Replication으로 복제본을 두는 방법도 있지만, 사람이 실수로 지운 데이터는 복제본에도 그대로 반영되니 복제가 백업을 대신하지는 못한다. 중요한 데이터라면 백업을 따로 챙겨야 한다.
Cache로 쓸 때는 키마다 TTL(만료 시간)을 반드시 붙인다. 메모리는 한정되어 있고, 캐시는 시간이 지나면 원본과 어긋나기 때문이다.
명령은 한 스레드에서 차례로 처리된다
Redis는 Single Thread로 명령을 처리한다. 여러 클라이언트가 동시에 요청을 보내도 명령은 하나씩 차례로 실행된다. 요청을 동시에 돌리지 않는 대신, 각 요청을 빠르게 끝내서 동시성을 감당한다.
이 구조 덕분에 Redis의 명령 하나하나는 원자적(Atomic)으로 실행되고, 경쟁 상태(Race Condition)가 생길 여지가 작다. 두 클라이언트가 같은 카운터를 동시에 올려도 명령이 겹쳐 실행되지 않는다.
반대로 한 클라이언트가 오래 걸리는 명령을 보내면 그동안 뒤에 줄 선 요청이 전부 기다리고, 이렇게 쌓인 요청은 장애로 이어질 수 있다. 싱글 스레드의 장점과 약점은 같은 곳에서 나온다.
참고로 Redis 6.0부터 네트워크 I/O를 여러 스레드로 나누는 옵션이 생겼지만, 명령 실행 자체는 여전히 한 스레드에서 이루어진다.
자료구조와 확장
Redis는 단순한 문자열만 담는 저장소가 아니다. String, List, Hash, Set, Sorted Set, Stream 같은 자료구조를 제공한다. 애플리케이션에서 직접 짜야 했던 로직을 Redis 명령 하나로 줄일 수 있어서 개발이 편해진다. 예전에 정리한 메모에는 list형 데이터의 입력·삭제가 MySQL보다 10배 빠르다고 적혀 있다.
여러 대로 확장하는 방법도 있다. 읽기 성능을 높이려면 서버 측 Replication으로 Master-Slave(최근 문서에서는 primary-replica라고 부른다) 구성을 만들어 읽기를 복제본으로 나눈다. 쓰기 성능이 문제라면 데이터를 여러 서버에 나눠 담는 샤딩을 쓴다. 예전에는 클라이언트가 키를 보고 어느 서버로 보낼지 정하는 클라이언트 측 샤딩이 일반적이었고, Redis 3.0부터는 서버가 샤딩을 맡는 Redis Cluster도 쓸 수 있다.
주로 어디에 쓰는가
여러 서버가 같은 데이터를 공유해야 할 때. 서버가 여러 대면 각 서버의 전역 변수는 서로 보이지 않는다. 서버가 한 대라 전역 변수로 충분해 보여도, 여러 스레드가 그 변수를 건드리면 동기화를 직접 챙겨야 한다. Redis는 명령이 원자적으로 실행되니 Thread Safe하게 쓸 수 있다.
인증 토큰 저장. String이나 Hash에 담는다.
랭킹 보드. 점수 순으로 정렬된 Sorted Set이 그대로 랭킹이 된다.
유저별 API 호출 제한.
Job Queue.
참고
Redis는 네트워크 너머에 있는 Key-Value 딕셔너리이고, 주로 Cache Server로 쓴다.
명령이 한 스레드에서 차례로 실행되니 원자적이지만, 오래 걸리는 명령 하나가 전체를 막는다.