nginx Pod를 3개에서 6개로 늘렸는데 처리량은 초당 5,300건 근처에서 그대로였다. Pod의 CPU와 메모리는 한도의 5~25%만 쓰고 있었다. 자원은 남는데 더 처리하지 못했다. 그 뒤로 Pod CPU limit, 사이드카 설정, Gateway 노드 사양을 차례로 키웠지만 숫자는 한 번도 움직이지 않았다.
마지막에 별 기대 없이 부하를 주는 서버를 한 대 더 붙였다. 서버 쪽은 아무것도 바꾸지 않았는데 합산 처리량이 8,823 RPS로 65% 올랐다. 5,300은 서버의 한계가 아니라 측정 방법이 만든 숫자였다.
하나의 서비스를 여러 고객사가 각자 쓰도록 바꾸는 멀티 테넌트 SaaS 전환 프로젝트에서, 운영에 올리기 전 처리 한도를 재던 중에 있었던 일이다. 한 곳에서 부하를 주면 결과가 왜 왜곡되는지, 그걸 바로잡으려고 들인 AWS Distributed Load Testing(DLT)이 무엇을 바꾸고 무엇을 못 바꾸는지 차례로 적는다.
빈 nginx로 인프라의 한도부터 쟀다
운영 전에 숫자로 답해야 할 질문은 두 가지였다. 이 인프라는 초당 몇 건까지 안정적으로 처리하는가, 그리고 트래픽이 갑자기 늘면 자동 확장이 따라오는가. 첫 질문에 답하려면 앱의 한계와 인프라의 한계를 나눠서 재야 하므로, 부하 대상도 둘로 나눴다. 정적 페이지만 주는 빈 nginx 컨테이너로 NLB, Istio Gateway, 사이드카까지의 한도를 먼저 재고, 실제 Spring Boot 백엔드(mo-back)는 그다음에 쟀다.
flowchart LR
    L["부하 발생기"] -->|"HTTPS"| NLB["NLB<br/>(L4)"]
    NLB --> GW["Istio Gateway Pod<br/>(HPA 2~10)"]
    GW --> SVC["Service"]
    SVC --> P1["nginx Pod 1<br/>nginx + istio-proxy"]
    SVC --> P2["nginx Pod 2<br/>nginx + istio-proxy"]
    SVC --> P3["nginx Pod 3<br/>nginx + istio-proxy"]
부하 도구는 k6였다. 처음에는 노트북에서 쐈는데, 같은 대상을 AWS 안의 bastion 서버에서 쏘자 RPS가 약 8배(749 → 5,170) 나왔다. 인터넷 왕복 시간이 측정을 잡아먹고 있었던 것이다. 그 뒤로 부하는 bastion 한 대에서 주는 것으로 표준화했다. 시나리오는 초당 요청 수를 목표로 올리는 ramping-arrival-rate였다.
// Pod 6개로 인프라 천장 확인 (1분 30초)
import http from 'k6/http';
import { check } from 'k6';

export const options = {
  scenarios: {
    finalShort: {
      executor: 'ramping-arrival-rate',
      startRate: 5000,
      timeUnit: '1s',
      preAllocatedVUs: 1000,
      maxVUs: 15000,
      stages: [
        { duration: '30s', target: 10000 },   // 30초 동안 초당 1만 건까지 올린다
        { duration: '60s', target: 10000 },   // 1분 유지
      ],
    },
  },
};

export default function () {
  const res = http.get('https://tenant-a.example.com/lt-nginx/index.html');
  check(res, { 'status is 200': (r) => r.status === 200 });
}
bastion으로 옮긴 덕분에 숫자는 커졌지만, 이번에는 그 숫자가 어디서도 더 오르지 않았다.
Pod를 두 배로, 노드를 네 배로 키워도 5,300이었다
의심 가는 곳을 하나씩 키워 봤다. 결과는 전부 같았다.
| 가설 | 바꾼 것 | 결과 |
|---|---|---|
| nginx Pod 수가 모자라다 | 3개 → 6개 | 약 5,300에서 정체 |
| Pod CPU limit이 낮다 | 1코어 → 2코어 | 변화 없음 (5,900 → 5,383) |
| 사이드카 worker 수가 모자라다 | concurrency 2 → 4 | RPS 그대로 |
| Gateway 노드 사양이 낮다 | t3.medium → c5.xlarge (4배) | 4,961 RPS |
| Gateway Pod와 NLB 타깃이 모자라다 | Gateway HPA 최소 15개, NLB 타깃 24개 | 5,043 RPS |
이상한 점이 하나 있었다. nginx Pod 3개의 사이드카 가운데 하나만 990m 근처까지 CPU를 쓰고, 나머지 둘은 470m 정도로 절반쯤 놀고 있었다. 부하는 고르게 나뉘어야 하는데 한 곳에 몰려 있었다. 이 무렵 나는 “Envoy의 한 경로가 1코어 부근에서 직렬화되는 고유한 한계”라는 가설까지 갔다. 사이드카 limit과 concurrency를 같이 올려도, Pod를 노드마다 하나씩 흩어도 그 사이드카는 990m 근처에서 멈췄기 때문이다.
자원이 남는데 처리량이 안 늘면 서버가 아니라 부하를 주는 쪽을 의심해야 했다. 그걸 깨닫기까지 일주일 가까이 서버 쪽만 키웠다.
부하 서버를 한 대 더 붙였다
다른 서버 쪽 가설이 떠오르지 않아 bastion을 한 대 더 띄워 두 대에서 동시에 부하를 줬다. nginx 설정은 직전 측정과 같다.
| 부하 서버 | 합산 처리량 | 오류율 | 가장 바쁜 사이드카 CPU | 사이드카 3개 합산 CPU |
|---|---|---|---|---|
| 1대 | 5,348 RPS | 0% | 907m | 약 1.9코어 |
| 2대 | 8,823 RPS (+65%) | 약 0.9% | 1,267m | 약 3.0코어 |
두 대의 몫은 각각 3,903과 4,920이었다. 놀던 사이드카 둘도 868m, 888m까지 올라왔고, 990m에서 막힌다던 사이드카는 1,267m까지 썼다. 1코어 한계라는 가설은 여기서 틀린 것으로 확정됐다.
출발지가 하나면 NLB와 Gateway가 같은 Pod를 고른다
쏠림은 두 단계에서 겹쳐 생긴다.
flowchart TD
    K["k6 (서버 1대 = 출발지 IP 1개)"] --> N["NLB<br/>출발지·목적지 정보로 대상 결정<br/>→ 출발지가 하나면 분배가 치우침"]
    N --> G["Gateway<br/>연결 단위로 뒤쪽 Pod 결정<br/>→ 같은 연결의 요청은 같은 Pod로"]
    G --> P1["Pod 1: 과부하"]
    G --> P2["Pod 2: 여유"]
    G --> P3["Pod 3: 여유"]
    P1 --> R["Pod 1의 한계가<br/>전체 한계처럼 보임"]
NLB는 L4 로드밸런서라 연결의 5-tuple(출발지 IP·포트, 목적지 IP·포트, 프로토콜)을 해시해 대상을 고른다. 같은 flow는 같은 대상으로 간다. 출발지 IP가 하나면 다섯 요소 가운데 셋이 고정되니 분배 폭이 좁아진다. 실제로 Gateway Pod를 25개까지 늘렸을 때도 부하 서버 한 대로는 일부 Gateway Pod만 일했고, 두 대로 늘리자 11개로 넓어졌다.
그 뒤의 Gateway(Envoy)는 연결 단위로 뒤쪽 Pod를 정한다. k6는 keepalive로 연결을 재사용하므로, 한 연결에 실린 수많은 요청이 처음 정해진 사이드카로 계속 간다. 앞 단계에서 치우친 연결이 뒷 단계에서 그대로 굳는다. 어느 Pod에 쏠릴지는 측정을 시작한 순간의 우연에 달려서, 라운드마다 바쁜 Pod가 달랐던 것도 이걸로 설명된다.
운영 환경은 다르다. 사용자 수만 명이 각자 다른 IP와 연결로 들어오므로 이 쏠림은 저절로 풀린다. 한 곳에서 잰 숫자를 운영 한도로 읽으면 실제 처리력을 한참 낮게 잡게 된다.
부하 도구 옵션으로는 우회할 수 없었다
출발지를 늘리기 전에, 부하 서버 한 대에서 쏠림을 피하는 방법도 시험했다. k6의 noConnectionReuse: true로 요청마다 새 연결을 맺게 하면 Gateway가 매번 Pod를 다시 고른다.
| 지표 | 연결 재사용 (기본) | noConnectionReuse: true |
|---|---|---|
| RPS | 5,115 | 800 (-84%) |
| k6가 보내지 못한 요청 | 초당 2,021 | 초당 3,999 |
| 사이드카 간 편차 (최대/최소) | 약 1.7배 | 1.21배 |
분배는 고르게 됐지만 요청마다 TLS handshake를 하느라 k6가 부하를 만들지 못했다. 사이드카는 limit의 10%만 쓰며 놀았다. 서버의 한도를 재려는 측정에서 부하가 안 만들어지면 의미가 없으니 접었다. k6를 다른 도구로 바꿔도 마찬가지다. NLB의 flow hash는 출발지 IP 수에 묶여 있다. NLB를 ALB로 바꾸면 쏠림은 사라지겠지만, 측정을 위해 운영 구조를 바꾸는 건 영향이 너무 컸다.
남은 답은 출발지를 늘리는 것뿐이었다. bastion을 계속 늘릴 수도 있었지만, 그러면 EC2를 직접 띄우고 관리해야 하고 결과도 서버마다 따로 grep과 awk로 모아야 한다. 대신 여러 Fargate 작업이 각자 다른 IP로 부하를 주는 AWS DLT를 들였다.
| k6 단일 서버의 한계 | DLT가 푸는 방식 |
|---|---|
| 출발지가 하나라 특정 Pod에 쏠림 | 여러 Fargate 작업이 각자 다른 IP로 동시에 부하 |
| 한 대에서 가상 사용자 수천을 만드느라 부하 도구 자체가 느려져 응답 시간이 길게 측정됨 | 작업마다 작은 부하만 맡아 도구가 가벼움 |
결과를 grep, awk로 수동 정리 | 웹 화면에 결과가 표시되고 S3에 보관 |
| 부하를 늘리려면 서버를 직접 추가 | Task Count 숫자만 바꾸면 됨 |
DLT로 같은 서버를 다시 쟀다
같은 nginx 3 Pod에 세 가지 방식으로 부하를 줬다.
| 부하 도구 | 출발지 수 | 처리량 | 오류율 | p95 응답 |
|---|---|---|---|---|
| k6, 서버 1대 | 1 | 5,115 RPS | 0.23% | 2,256ms |
| k6, 서버 2대 | 2 | 8,823 RPS | 약 0.9% | 약 4,000ms |
| DLT, 작업 3개 | 3 | 6,644 RPS | 0% | 97ms |
DLT 측정은 Task 3개 × Concurrency 100, 동시 사용자 300명으로 1분 30초 동안 59만 8,024건을 보냈고 오류는 0건이었다. 가장 크게 바뀐 건 p95 응답 시간으로, 2,256ms가 97ms가 됐다.
DLT는 서버를 빠르게 하지 않는다
표만 보면 DLT를 쓰니 오류가 사라지고 응답이 23배 빨라진 것처럼 보인다. 처리량과 오류는 서버가 정한다. DLT가 바꾼 건 부하가 서버에 닿는 모양이다.
오류율 0.23% → 0%. 5xx는 서버가 돌려준다. k6 한 대일 때는 한 사이드카에 쏠려 그 사이드카만 여유가 없다 보니 일부 요청이 실패했다. DLT는 부하를 고르게 보내 그런 상황을 애초에 만들지 않았다.
처리량 5,115 → 6,644. 한 Pod만 먼저 한계에 닿지 않으니 합산으로 더 처리됐다.
p95 2,256ms → 97ms. 두 효과가 섞여 있다. k6 한 대가 수천 명분의 가상 사용자를 만드느라 스스로 느려진 측정 노이즈가 빠졌고, 쏠린 사이드카에서 실제로 늦던 응답도 사라졌다.
같은 매장에 손님이 한 줄로만 서느냐, 세 줄로 나눠 서느냐의 차이다.
RPS보다 성공률과 오류 코드를 먼저 본다
DLT를 쓰면서 하나 더 익숙해져야 했던 건 RPS가 입력이 아니라 결과라는 점이다. k6의 ramping-arrival-rate는 초당 요청 수를 목표로 준다. DLT는 동시 사용자 수(Task Count × Concurrency)만 정하고, RPS는 응답 시간에 따라 따라 나온다. 대략 RPS ≈ 동시 사용자 수 / 평균 응답 시간이다.
그래서 RPS가 낮다고 서버가 약하다고 단정할 수 없다. 실제 화면 초기화 API(/main/init)를 동시 사용자 200명으로 쳤을 때 RPS는 25였고 평균 응답은 15초였다. 100명일 때보다 RPS는 4.6% 많았을 뿐이고, 평균 응답은 두 배로 길어졌다. 이 RPS는 서버가 바빠서 낮았던 게 아니다. 한 건이 오래 걸렸고, 그 원인은 DB 조회와 외부 연동이었다.
반대로 RPS가 비정상적으로 높을 때도 의심해야 한다. 아래는 DLT 결과 화면이다.
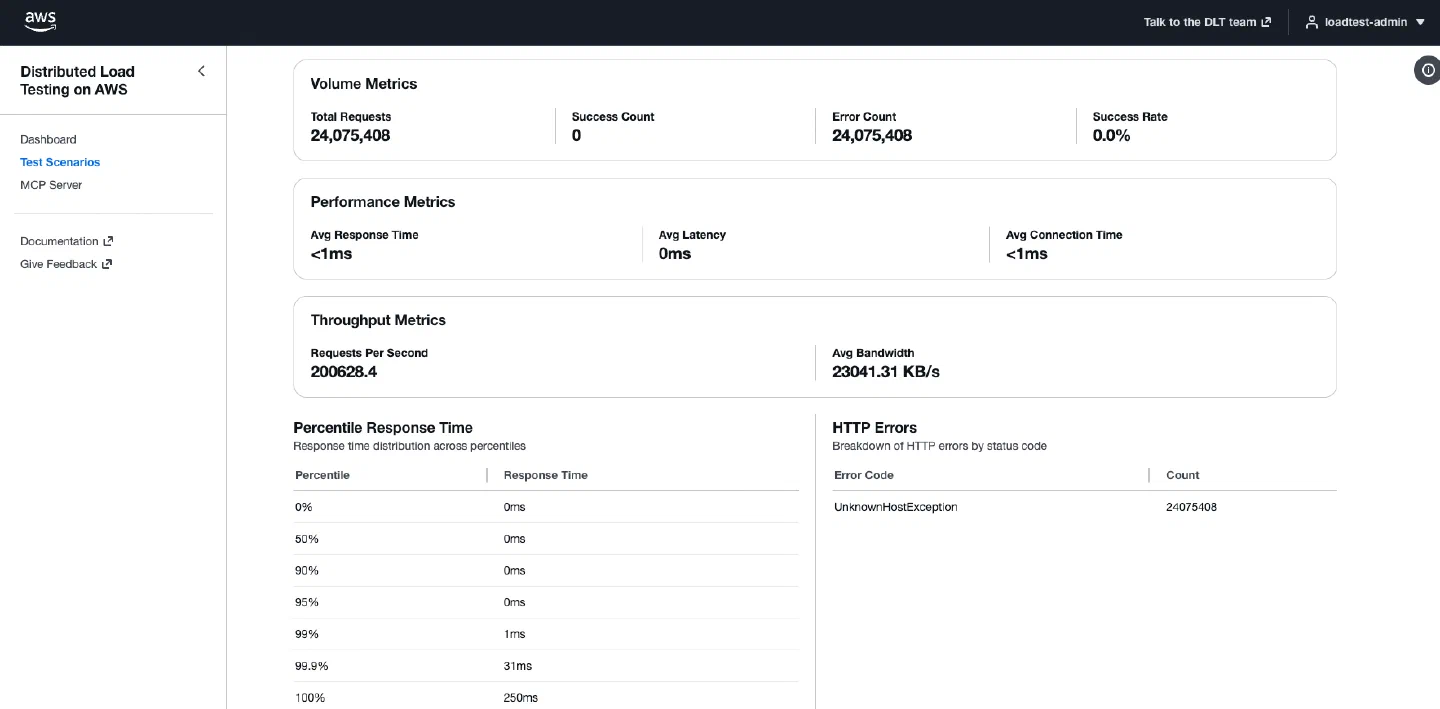
Requests Per Second는 200,628.4로, nginx로 잰 인프라 한계 8,800의 20배가 넘는다. 그런데 Success Count는 0이고 Success Rate는 0.0%다. 2,407만 5,408건이 전부 UnknownHostException으로 실패했다. 대상 호스트 이름이 IP로 해석되지 않아 요청이 서버에 닿기도 전에 끝났다. 실패가 1ms도 안 걸려 돌아오니 같은 동시 사용자가 초당 20만 번을 “보낸” 셈이 됐고, 평균 응답 시간도 1ms 미만으로 찍혔다. 동시 사용자 수만 정하는 도구에서 RPS는 응답이 빠를수록 커지고, 실패는 가장 빠른 응답이다.
결과 화면에서는 Success Rate와 HTTP Errors 표를 먼저 보고, 성공률이 정상일 때만 RPS와 p95를 읽어야 한다. 측정 가이드에도 실행 전에 대상 도메인이 외부 DNS에서 해석되는지 nslookup으로 확인하는 단계를 넣어 두었다. DLT는 퍼블릭 인터넷에서 부하를 쏘기 때문에 VPC 안에서만 풀리는 이름은 찾지 못한다.
Task를 10개로 늘려도 Pod 간 2배 차이는 남았다
DLT로 출발지를 늘렸으니 Pod 간 쏠림도 풀렸을 거라 생각했는데, 반만 맞았다. 작업 3개일 때 가장 바쁜 사이드카와 가장 한가한 사이드카의 CPU 차이는 1.92배였다. 출발지가 3개뿐이라 우연한 편향일 수 있어서 Task를 10개로 늘렸다. RPS는 6,670으로 거의 같았고, 차이는 2.03배로 오히려 조금 커졌다.
NLB까지는 고르게 들어오고 있었다. CloudWatch의 NLB NewFlowCount가 분당 1,000을 넘었고, 동시 활성 flow도 1,069로 동시 사용자 1,000명과 맞았다. DLT VPC는 NAT 없이 Internet Gateway에 바로 붙어 있어 작업마다 자기 IP로 나가는 것도 확인했다. 출발지를 늘려서 풀리는 건 NLB까지였고, Gateway 뒤의 쏠림은 출발지 수와 상관이 없었다.
원인은 서버 쪽에 있었다. nginx Pod 3개가 가용 영역 두 곳에 2:1로 나뉘어 있었고, Istio는 기본으로 같은 가용 영역의 Pod를 우선하는 locality 로드밸런싱을 한다. 한쪽 영역의 Gateway로 들어온 트래픽은 그 영역의 Pod 하나가 혼자 받고, 다른 쪽은 Pod 둘이 나눠 받는다. 2배 차이가 정확히 이 구조에서 나온다. 분배 알고리즘을 LEAST_REQUEST로 바꾸는 것만으로는 이 차이가 남았다.
DestinationRule에 localityLbSetting: false를 넣고 다시 재자 사이드카 간 차이가 1.04배로 사라졌다. 대가도 있었다. 가용 영역을 건너는 요청이 생겨 RPS가 6,125에서 4,928로 20% 줄고 평균 응답이 25% 늘었다. 그래서 최종 템플릿에는 분배 설정과 함께 Pod를 가용 영역과 노드에 고르게 까는 topologySpreadConstraints를 모든 앱에 넣었다.
trafficPolicy:
  loadBalancer:
    simple: LEAST_REQUEST                 # 새 연결은 요청이 적은 Pod로
    warmupDurationSecs: 60s               # 새 Pod는 60초에 걸쳐 트래픽을 늘린다
    localityLbSetting: { enabled: false } # 같은 가용 영역 우선을 끈다 (영역 간 Pod 수가 다를 때의 쏠림 방지)
같은 DestinationRule의 연결 풀 쪽에는 실제 앱 처리량을 6분의 1로 묶고 있던 설정 한 줄이 따로 있었다. 그 이야기는 826 RPS에서 멈춘 건 앱이 아니었다에 있다.
DLT를 설치하고 시나리오를 만들 때 알아둘 것
설치는 한 번, 네트워크는 새 VPC로
AWS 콘솔의 Launch Wizard에서 옵션을 고르면 15~25분 뒤 CloudFormation 스택으로 구축된다.
| 항목 | 선택 | 이유 |
|---|---|---|
| 배포 방식 | CloudFront Deployed Web Console | AWS 권장. 웹 화면 제공. ALB 방식은 비용이 더 들고 Headless는 화면이 없다 |
| 네트워크 | Create new VPC | 기존 VPC의 private subnet에서 NAT로 나가면 출발지가 NAT의 IP 하나로 묶여 “여러 곳에서 쏘는” 효과가 사라진다 |
| 관리자 이메일 | 담당자 | 임시 비밀번호가 메일로 온다. 첫 로그인 때 바꾼다 |
| 컨테이너 자동 업데이트 | Enable | 보안 패치 |
| MCP server | Disable | 우리 용도에는 필요 없었다 |
설치할 때 가장 신경 쓴 선택이 네트워크다. DLT를 들이는 이유가 출발지를 여러 개로 만드는 것이니, 기존 VPC에 붙이면 도입 이유가 사라진다.
시나리오는 네 단계, 부하는 Task × Concurrency
flowchart LR
    S1["1. General<br/>이름, Run Now"] --> S2["2. Scenario<br/>무엇을 칠지"]
    S2 --> S3["3. Traffic Shape<br/>얼마나 줄지"]
    S3 --> S4["4. Review<br/>확인 후 실행"]
2단계에서 주소 하나만 칠 때는 Single HTTP Endpoint를 고르고 URL과 메서드만 넣는다. 로그인해서 받은 토큰을 헤더에 넣는 식으로 여러 단계가 필요하면 JMeter를 고르고 미리 만든 .jmx 파일을 올린다. 실제 앱 API는 JMeter 시나리오로 쟀다.
3단계 Traffic Shape에서 실제 부하가 정해진다.
| 설정 | 뜻 | 사용한 값 |
|---|---|---|
| Task Count | 부하를 쏘는 위치(Fargate 작업) 수 | 2~20 |
| Concurrency | 작업 하나당 동시 사용자 수 | 100~200 |
| Ramp Up | 목표까지 올리는 시간 | 30초 |
| Hold For | 그 부하를 유지하는 시간 | 1~5분 |
총 동시 사용자는 Task Count × Concurrency로, 3 × 100이면 300명이다. Ramp Down 설정은 없어서 Hold For가 끝나면 바로 멈춘다. 결과표에 “Concurrency 200”이라고 적을 때 그게 작업당 값인지 총합인지 헷갈린 적이 있어서, 기록에는 Task와 Concurrency를 따로 적는 게 낫다.
돌리면서 걸린 것들
| 주의 | 설명 |
|---|---|
| 같은 시나리오 반복 | Copy가 아니라 Edit으로 들어가야 올린 .jmx 파일이 유지된다 |
URL 끝의 / | 라우팅 규칙이 /lt-nginx/처럼 끝에 /가 있으면 정확히 맞춰야 한다 |
| 시작이 느리다 | Queued → Running → Complete. Fargate 준비로 시작에 2~5분 걸리는 게 정상이다 |
| Fargate 작업 시작 실패 | 용량 일시 부족이나 연속 실행 충돌로 간헐적으로 난다. 다시 실행하면 됐다 |
| 서버 지표는 따로 | DLT는 클라이언트 관점만 본다. Pod CPU는 kubectl top으로 5~15초 간격으로 같이 기록했다 |
비용은 측정 한 번에 약 $0.04였지만, 스택을 켜 둔 동안 월 4만 원대의 고정비가 나갔다. 정기 측정이 없는 기간에는 스택을 내려 두고 필요할 때 다시 배포한다.
아직 남은 문제
클러스터의 진짜 상한은 아직 모른다. 부하 서버 2대로 잰 8,823이 서버의 한계인지 부하 쪽 한계인지는 가르지 못했다. 이후 DLT로 HPA와 Karpenter를 켜고 잰 nginx 한계는 9,268 RPS였다.
DLT도 운영 트래픽을 흉내 내지는 못한다. Task 10개는 출발지 10개다. 수만 명의 사용자가 만드는 연결 분포와는 여전히 거리가 있다.
모든 숫자는 dev 환경 값이다. DB와 노드 사양이 다른 운영 환경에서는 같은 측정을 한 번 더 해야 한다.
정리
Pod, CPU limit, 사이드카, Gateway 노드를 차례로 키워도 5,300 근처였던 처리량은 부하 서버를 한 대 더 붙이자 8,823이 됐다. 출발지가 하나면 NLB의 flow hash와 Gateway의 연결 고정이 겹쳐 한 Pod의 한계가 전체 한계처럼 보인다.
같은 nginx 3 Pod를 k6 한 대로 치면 5,115 RPS에 p95 2,256ms, DLT 작업 3개로 치면 6,644 RPS에 97ms였다. 서버 쪽은 그대로였다.
동시 사용자 수만 정하는 도구에서는 Success Rate와 오류 코드를 먼저 보고 RPS를 읽는다. 전부 실패한 측정이 초당 20만 건을 찍었다.
출발지를 10개로 늘려도 남은 Pod 간 2배 차이는 가용 영역 배치와 locality 설정, 서버 쪽에서 풀어야 했다.
부하테스트에서 처음 정해야 할 건 목표 RPS가 아니라 부하를 몇 군데서 보낼지다.