저장소는 하나였다. 안에 든 코드는 A라는 기존 템플릿에 B 템플릿을 합친 형태였다. 한 도메인 안에서 A 화면과 B 화면이 섞여 쓰여야 했고, 양쪽에 있는 스타일과 기능 코드를 서로 가져다 쓰기 편하게 하려고 아예 합쳐버린 것이다.
합친 이유는 편의였지만, 애플리케이션이 커지면서 패키지 충돌이 점점 늘었다. 처음부터 다시 설계해 나누는 게 맞다고 판단했고, 그때 고른 구조가 Monorepo다. 이 글에서는 Monorepo가 무엇인지 짧게 짚고, Nx로 나눈 뒤 달라진 점과 아직 풀리지 않은 의문을 적는다.
여러 프로젝트를 한 저장소에 두는 방식
Monorepo는 여러 프로젝트의 코드를 하나의 저장소에서 관리하는 방식이다. 큰 소프트웨어가 여러 서브 프로젝트로 나뉘어 있을 때, 서브 프로젝트마다 저장소를 따로 두는 대신 모든 코드를 한곳에 모은다.
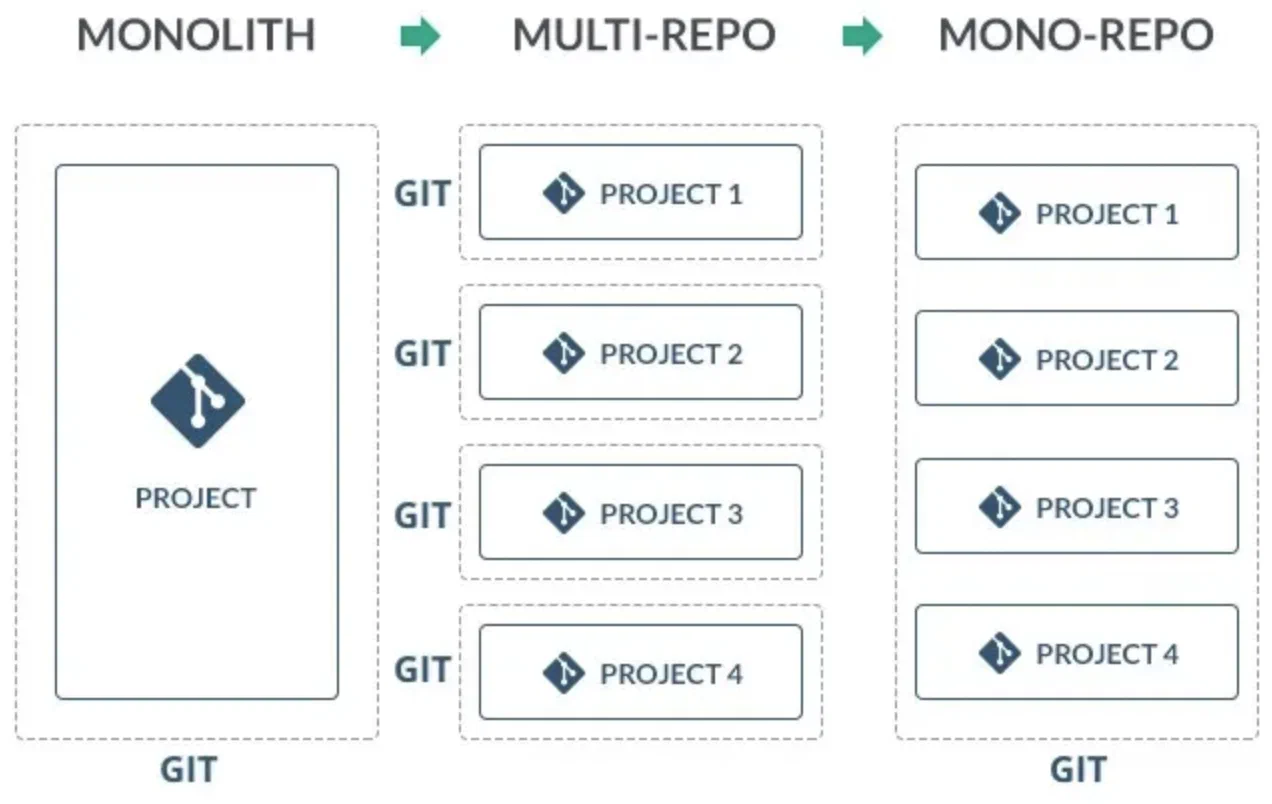
출처: Moving from multiple repositories to a lerna-js mono-repo
그림으로 보면 차이가 분명하다. Monolith는 프로젝트 하나가 저장소 하나고, Multi-repo는 프로젝트마다 저장소가 따로 있다. Mono-repo는 저장소는 하나인데 그 안에서 프로젝트가 나뉜다. 우리 저장소는 A와 B가 경계 없이 뒤섞인 Monolith에 가까웠고, 옮겨 가려는 곳은 오른쪽 끝이었다.
장점은 세 가지로 정리된다.
버전 관리가 한곳에 모인다. 모든 코드가 한 저장소에 있으니 의존성 관리가 수월하고, 버전 충돌을 풀거나 코드베이스 전체를 한 번에 업데이트하기 쉽다. 동시에 서브 프로젝트로 경계가 나뉘기 때문에 프로젝트마다 다른 버전의 의존 패키지를 쓰는 것도 쉬워진다. 확장하기 좋은 구조라는 뜻이다.
공통 코드를 재사용하기 쉽다. 여러 곳에서 쓰는 코드나 라이브러리를 공유할 수 있어 중복이 줄어든다.
팀 간 협업이 편해진다. 다른 서브 프로젝트를 맡은 개발자도 필요한 정보를 찾고 변경 사항을 파악하기 쉽다.
단점도 있다.
규모가 커지면 관리가 복잡해진다. 저장소가 방대해질수록 빌드 시간도 늘어난다.
접근 권한을 나누기 어렵다. 여러 프로젝트가 한 저장소에 있으면 특정 부분만 접근을 막기가 까다롭고, 그만큼 보안 리스크가 커질 수 있다.
도구는 Nx로 골랐다
기존 애플리케이션을 Monorepo로 다시 짜는 데 쓸 수 있는 도구로는 Yarn workspaces, Lerna, Nx, Turborepo 등이 있다. 나는 이 중에서 Nx를 썼다.
A와 B는 apps/ 아래 각각의 앱으로 나눴고, 루트 package.json의 scripts로 앱별 실행과 빌드를 묶었다.
"scripts": {
  "start:A": "npx nx serve A --port 3005",
  "start:B": "npx nx serve B --port 3006",
  "start:all": "npm-run-all --parallel start:A start:B",
  "build:A": "npx nx run A:build",
  "build:B": "npx nx run B:build",
  "build:generate": "(cd apps/A && npx nuxi generate  --dotenv .env.production) && (cd apps/B && npx nuxi generate)"
},
두 앱은 포트를 3005, 3006으로 나눠 따로 띄우고, 함께 띄울 때는 npm-run-all --parallel로 둘을 동시에 실행한다. 빌드는 nx run <앱>:build로 앱마다 따로 돌리는데, 정적 파일을 뽑는 build:generate만은 Nx를 거치지 않고 각 앱 디렉터리로 들어가 nuxi generate를 직접 부른다. A만 .env.production을 읽도록 --dotenv를 붙인 점도 눈여겨볼 부분이다.
나누고 나서 달라진 것
처음 목적은 의존성 충돌을 줄이는 것뿐이었는데, 실제로 얻은 건 그보다 많았다. 서브 앱끼리 상호작용하는 지점을 빠르게 찾을 수 있게 되어 작업이 수월해졌다. 불필요한 코드 중복이 크게 줄었고, 전체 프로젝트의 코드 히스토리도 한눈에 들어온다. 빌드와 배포 역시 전보다 훨씬 단순해졌다.
아직 남은 의문
모든 게 한 저장소로 모이다 보니 특정 서브 프로젝트의 커밋 히스토리만 따로 추적하는 일은 예전보다 번거로워질 것 같다.
규모도 걸린다. 우리 프로젝트는 서브 프로젝트가 2~3개뿐이라 Monorepo의 이점을 크게 봤지만, 서브 프로젝트가 훨씬 많아져도 이 방식이 효율적일지는 아직 모르겠다. 그 정도 규모라면 Multi-repo가 더 나을 수도 있다고 본다.